モデルの中身:決定木の可視化とSHAPの依存プロット
機械学習のモデルは、何を見て予測しているのかが外から分かりにくいものです。このソフトには、学習したモデルの中身を確認する画面が2つあります。決定木の可視化ではモデルを構成する木を1本ずつ図で確認でき、SHAPの依存プロットでは特徴量の値と予測への影響の関係をグラフで確認できます。
どちらの画面も、デフォルトのモデルだけでなく自分で学習したモデルにも使用できます。特徴量を変えて学習し直したときに、モデルの見ているところがどう変わったかを確かめられます。
決定木の可視化
[表示] - [決定木の可視化] で開きます。予測モデル(LightGBM)は、小さな決定木を何本も足し合わせて予測します。デフォルトのメインのモデルは、芝・ダートとも千本以上の木で構成されています。この画面ではその木を1本ずつ図にして表示します。
木の選択
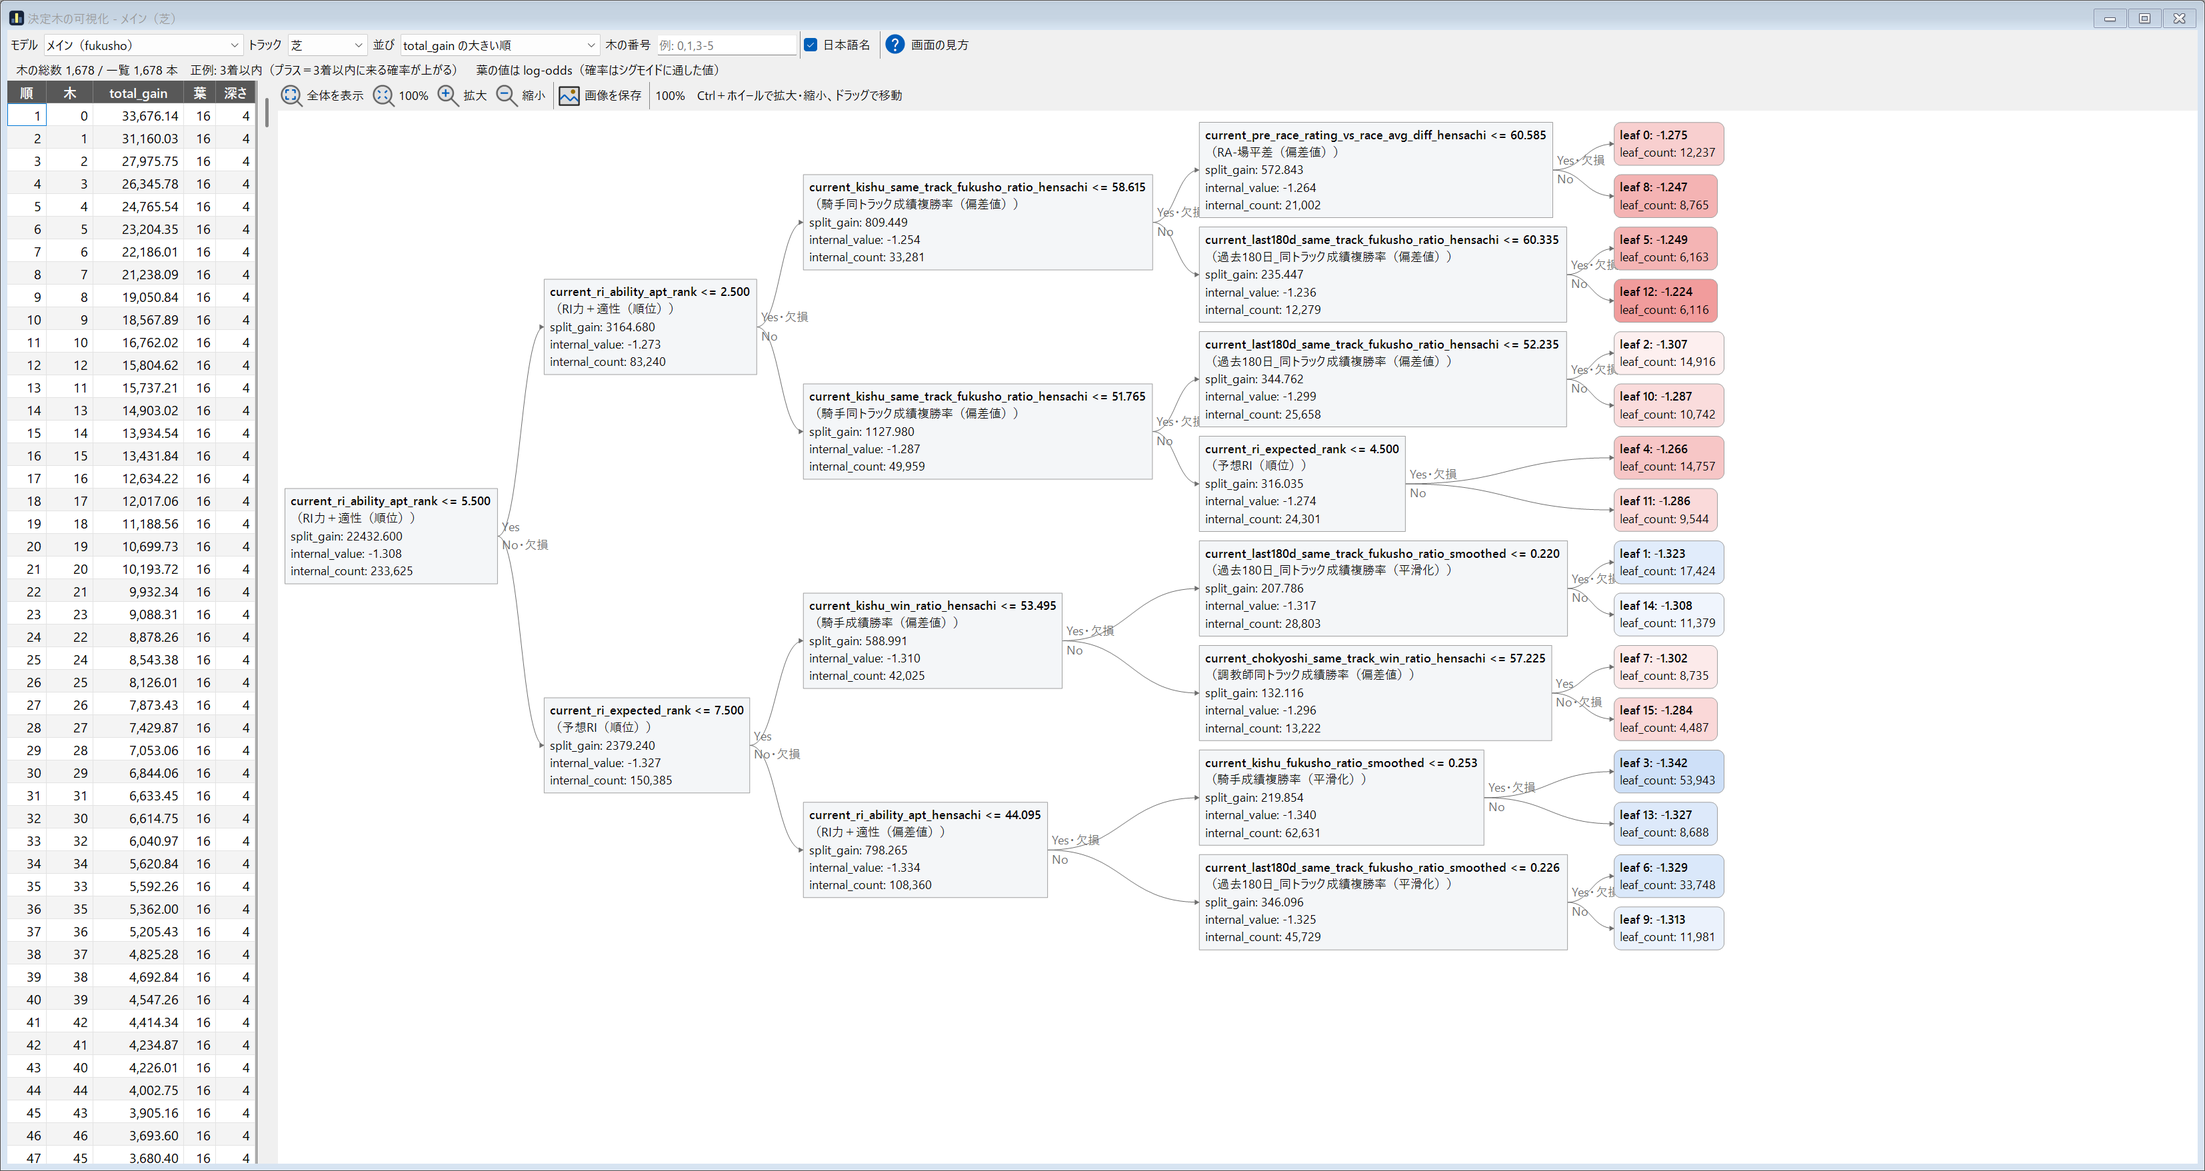
上でモデルとトラックを選択すると、左にそのモデルの木の一覧を表示します。一覧の並びは、total_gain(その木の分岐で予測がどれだけ改善したかの合計)の大きい順か、木の番号の順を選択できます。「木の番号」に「0,1,3-5」の形式で入力すると、一覧を絞り込めます。一覧で選んだ木を右に大きく描きます。
図の読み方
木は左の根から右の葉へ向かって分かれていきます。分岐の箱には分岐の条件と数値を表示します。
- 分岐の条件:「特徴量 <= しきい値」の形式です。「日本語名」を選択すると特徴量の日本語の名前も添えます
- 上の枝(Yes):条件を満たす馬が進みます
- 下の枝(No):条件を満たさない馬が進みます
- 欠損:特徴量の値が無い馬が進む側の枝に「欠損」と表示します
- split_gain:その分岐で予測がどれだけ改善したか
- internal_value:その分岐まで進んだ馬の平均的な値
- internal_count:学習のときにその分岐を通った件数
右端の葉の値は、その葉にたどり着いた馬の予測(log-odds。確率をシグモイド関数に通す前の値)に足される量です。葉は、その木の平均より上なら赤、下なら青で塗り、差が大きいほど濃くします。画面の上部には、そのモデルが何を当てるモデルか(例:3着以内)を表示するので、プラスとマイナスの意味を取り違えません。
上の例では、デフォルトのメインのモデル(芝)でいちばん貢献の大きい木の最初の分岐が「RI力+適性(順位)が5.5以下か」になっています。レースの中でRIの力と適性の順位が上位の馬かどうかで、最初に大きく分けていることが分かります。
操作
Ctrl+ホイールで拡大・縮小できます。ドラッグで移動できます。「全体を表示」「100%」で表示の倍率を切り替え、「出力」の「画像(PNG)」で木の図をPNGに保存します。
SHAPの依存プロット
[表示] - [SHAPの依存プロット] で開きます。SHAPは、1頭ごとの予測を特徴量ごとの寄与に分解する方法です。ある馬の予測が平均より高いとき、どの特徴量がどれだけ押し上げたかを数値で表します。依存プロットは、たくさんの馬についてこの寄与を集め、特徴量の値と寄与の関係をグラフにしたものです。
計算の条件
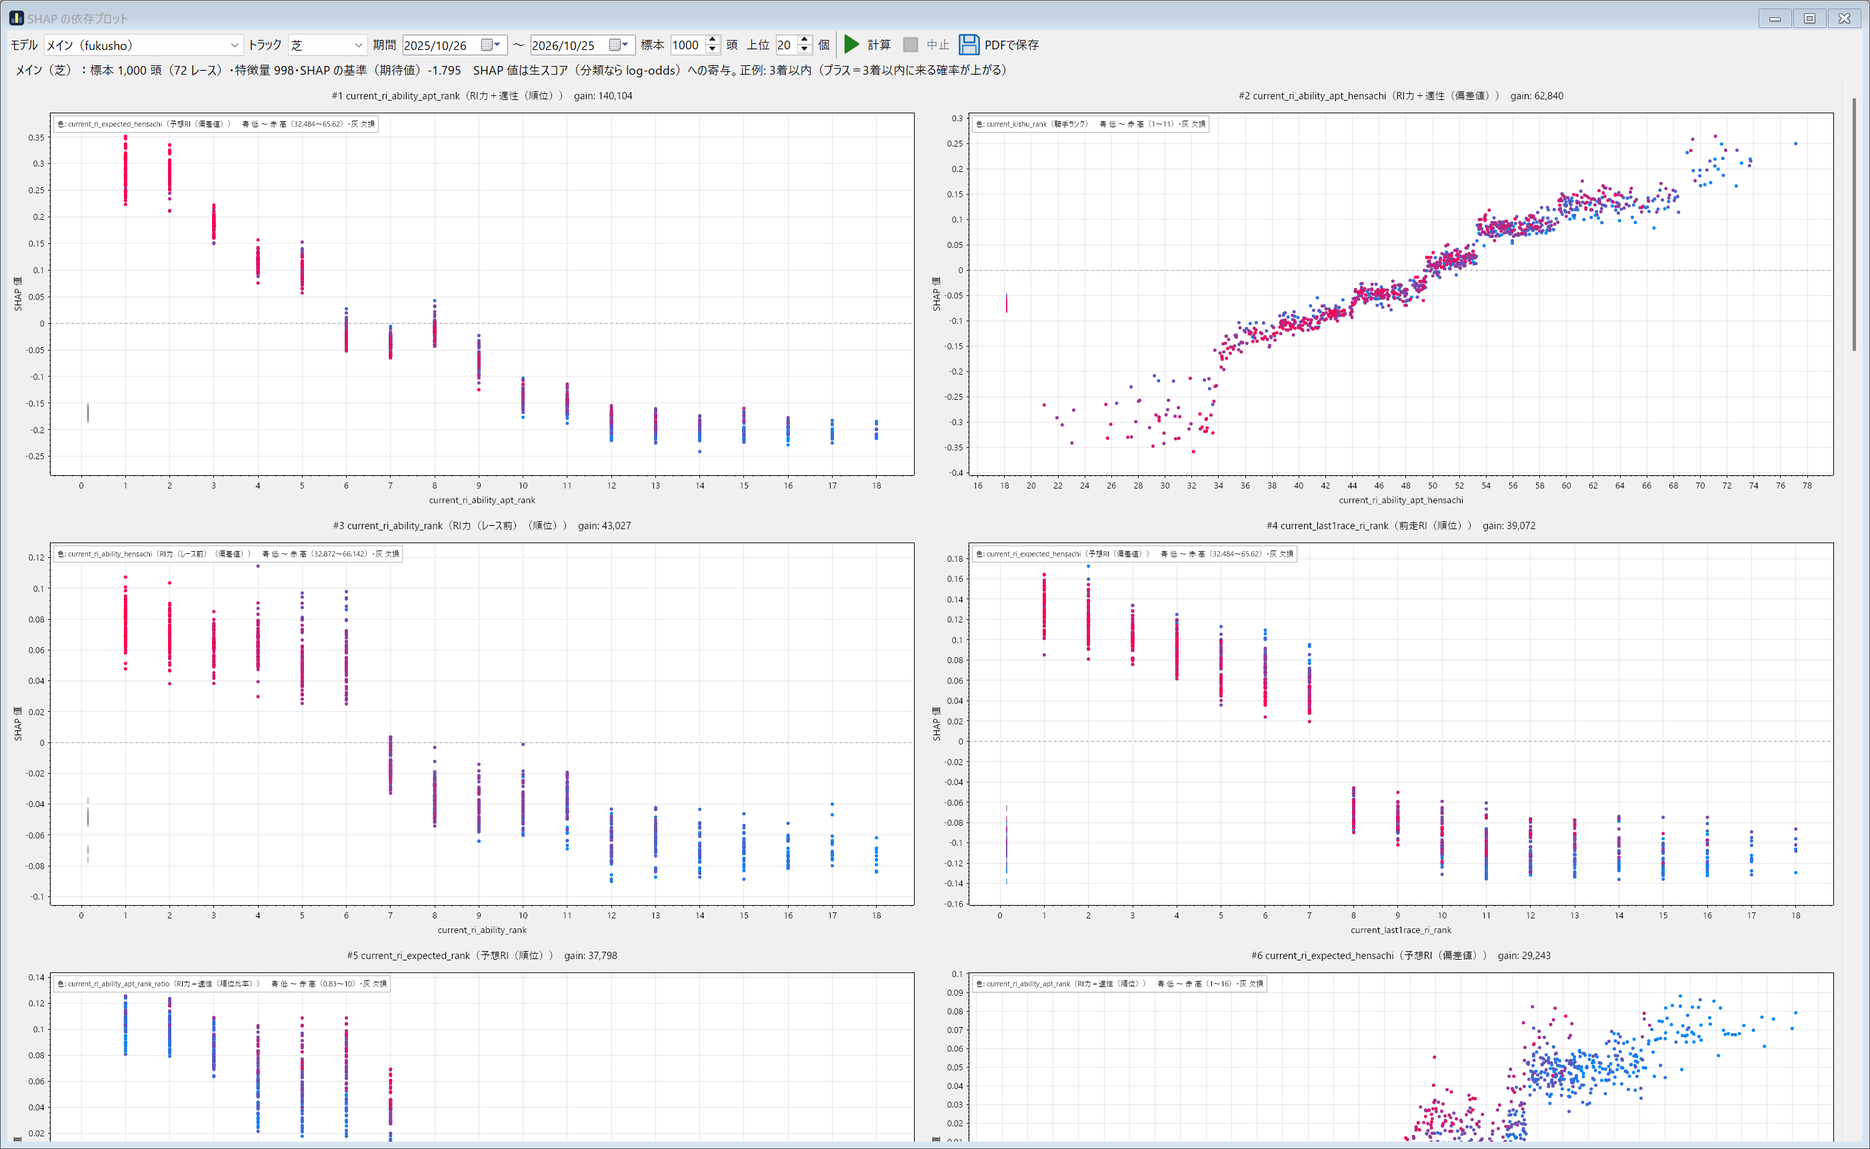
モデル・トラック・期間・標本の数(既定は1,000頭)・上位の数(既定は20個)を選択して「計算」を押します。期間のレースから無作為に馬を選び、出馬表と同じ計算で特徴量を作成して予測し、SHAPの値を算出します。重要度(split_gainの合計)の上位の特徴量ごとに、グラフを1つずつ描きます。計算はその場で行います。1,000頭で20秒ほどです。
グラフの読み方
- 横軸:その特徴量の値
- 縦軸:SHAPの値(予測のlog-oddsを押し上げた量。プラスは当たりやすい方向でマイナスは当たりにくい方向)
- 点の色:その特徴量といちばん関係が強そうな別の特徴量の値(青が低く、赤が高い)
- 左端の縦の印:特徴量の値が無い馬
- 点線:SHAPの値が0の線
点の並びが右上がりなら、値が大きいほど予測を押し上げる特徴量です。同じ横の位置でも点の色によって高さが違えば、色に使った特徴量との組み合わせで効き方が変わっていると読み取れます。
上の例のいちばん左上のグラフは「RI力+適性(順位)」です。順位が1〜2位の馬はSHAPの値がおよそ+0.2〜+0.35で、3位・4〜5位と下がるにつれて小さくなり、6〜8位で0の前後、10位より下では−0.15〜−0.2ほどになっています。点の色は予想RIの偏差値で、順位が上の馬ほど赤い(予想RIも高い)ことが分かります。
その右の「RI力+適性(偏差値)」は、偏差値がおよそ34より低いところで大きなマイナスになり、そこから右上がりに続いて、52前後でプラスに転じています。値が大きいほど3着以内に来やすいと、モデルが判断していることが分かります。
PDFでの保存
「出力」の「PDF」で、表示しているグラフをまとめて1つのPDFに保存します。A4横のページに4つずつ並べ、各ページにモデル・トラック・期間と標本の条件を記載します。
あわせて使う画面
1頭ごとの予測の理由は出馬表の「内訳」で確認できます。SHAPの値を材料のグループごとに合計して、その馬の予測が高い・低い理由を表示します。モデル全体の傾向は依存プロットで、個々の馬の理由は内訳で確認するという使い分けです。
戻る:予測モデル